PyPTO简介#
PyPTO(发音:pai p-t-o)是CANN推出的一款面向AI加速器的高效算子编程框架,采用PTO(Parallel Tensor/Tile Operation)编程范式,旨在简化算子开发流程,同时保留高性能计算能力。PyPTO提供PyPTO Tensor和PyPTO Pro两种编程方式,开发者可以根据算子开发效率、性能调优需求和硬件控制粒度进行选择。
编程方式 |
核心差异 |
适用场景 |
|---|---|---|
PyPTO Tensor |
采用Tensor级编程和MPMD(Multiple Program Multiple Data,多程序多数据)执行模型。开发者主要描述计算逻辑,由编译器完成Tile切分、内存分配、任务调度和代码生成,抽象层次较高。 |
适合希望以接近数学表达式的方式快速开发算子的开发者,以及通用深度学习算子、大模型组件和动态Shape等场景。 |
PyPTO Pro |
采用Kernel级编程和SPMD(Single Program Multiple Data,单程序多数据)执行模型。开发者可显式控制多核分工、数据搬运、Tile计算和流水编排,硬件控制粒度更细。 |
适合熟悉硬件架构、需要精细调优的开发者,以及Cube与Vector融合、复杂流水和追求极致性能的算子场景。 |
PyPTO Tensor#
核心架构#
PyPTO Tensor采用分层架构,从用户接口到底层硬件执行包括以下层次:
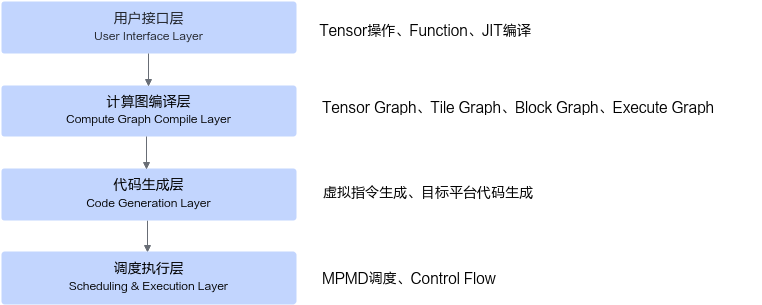
用户接口层:提供Python风格的Tensor编程接口,开发者可以直接表达计算逻辑,无需关注底层硬件指令。
计算图编译层:通过模块化Pass完成多层级计算图的转换与优化。
Tensor Graph面向算法表达,描述高层Tensor计算。
Tile Graph将Tensor计算展开为硬件感知的Tile计算,并进行布局变换、内存类型分配和数据搬运等优化。
Block Graph将Tile图切分为可并行执行的计算子图,并进行乱序调度、内存复用和同步点插入等优化。
Execute Graph整合计算子图及其依赖关系,形成最终执行图。
代码生成层:根据Execute Graph生成PTO虚拟指令代码,并进一步编译为目标平台代码。
调度执行层:将可执行代码以MPMD方式调度到设备处理器核,并负责依赖关系和控制流的执行。
核心特性#
Tensor级编程:以Tensor为基本数据单位,编程表达贴近算子的数学定义。
多层级计算图:通过Tensor Graph、Tile Graph、Block Graph和Execute Graph逐级降低抽象层次,为不同阶段的优化保留信息。
自动编译与调度:自动完成Tile切分、布局变换、内存分配、数据搬运、子图切分、同步和代码生成等工作。
MPMD执行模型:根据计算子图和资源情况生成多个程序,并调度到不同处理器核并行执行。
动态Shape与符号化编程:支持动态Batch Size等动态Shape场景。
工具链支持:支持查看各编译阶段的中间计算图和运行时性能数据,并提供编译及调度控制能力。
设计理念#
PyPTO Tensor以“算法表达与硬件执行解耦”为主要设计理念。开发者使用Tensor描述计算,将硬件相关的切分、搬运、流水和调度交由编译器处理,在降低算子开发门槛的同时保留全局优化空间。
计算层:尽可能贴近算法设计者的数学表达式,以Tensor而非单个元素描述计算,为内存布局、数据搬运和多算子联合优化保留完整信息。
编译层:通过多阶段Lowering Pipeline将Tensor Graph逐步转换为Tile Graph、Block Graph和Execute Graph,把高层计算映射为硬件友好的执行形式。
执行层:根据编译结果生成PTO虚拟指令和目标平台代码,并通过MPMD方式在设备侧并行执行。
工具链:提供编译中间产物和运行时性能数据的可视化能力,支持开发者定位问题并按需控制编译与调度行为。
产品支持情况#
Ascend 950PR/Ascend 950DT:支持
Atlas A3 训练系列产品/Atlas A3 推理系列产品:支持
Atlas A2 训练系列产品/Atlas A2 推理系列产品:支持
PyPTO Pro#
核心架构#
PyPTO Pro是面向AI Core Kernel开发的Python DSL,接口分为SIMD API、SIMT API和Utils API。SIMD API覆盖Tile计算、Reg计算、Cube计算以及数据搬运、资源管理和同步控制;SIMT API用于逐线程计算;Utils API提供Python语法辅助与调试能力。
图1 PyPTO Pro总体架构

开发者在Kernel核函数中声明参数和执行域,组织GM与片上Buffer之间的数据搬运,并选择Tile、Reg、Cube或SIMT计算方式。使用@pypto_pro.language.jit()声明的Kernel在首次启动时触发编译,之后可在相同编译签名下复用编译结果。
编译与执行过程包括以下阶段:
前端解析:绑定Kernel参数和启动配置,解析函数体并生成PyPTO IR。
IR优化与代码生成:对PyPTO IR进行校验和转换,由CCE CodeGen生成目标代码及Host侧Launcher。
编译与加载:编译并加载当前Kernel的JIT产物;相同编译签名可在当前进程中复用。
任务下发:Launcher将Kernel提交到指定Stream,由AI Core执行。
核心特性#
SPMD并行执行:一次Kernel启动可使用多个AI Core,各核通过核索引确定自身负责的数据分片。启动参数
block_dim配置实际参与执行的Vector核、Cube核或CV执行组数量,具体含义由Kernel执行域决定。分层计算能力:SIMD API同时提供Tile、Reg和Cube三类计算方式,分别面向片上数据块、矢量寄存器和矩阵计算;SIMT API用于表达逐线程索引、分支和原子更新。
显式数据组织:Tensor表示GM中的多维数据,Tile和TileGroup描述片上数据及多Buffer轮转,RegTensor和MaskReg用于Reg计算。数据搬运、布局和有效区域均由Kernel明确表达。
同步与流水:开发者可显式设置不同Pipe及不同核之间的依赖,也可基于TileGroup的mutex元数据使用自动同步;CV融合场景还支持按
stage编排跨核流水。编译期特化:STATIC维度、TilingKey和数据类型的取值不同时,JIT可以生成对应的Kernel版本;DYNAMIC维度和TilingData在运行时传入,取值变化时通常可以复用已有版本。
设计理念#
PyPTO Pro让开发者用Python编写Kernel,同时保留对硬件执行方式的控制。开发者可以根据算子特点安排数据分块、多核分工、片上Buffer的使用,以及搬运、计算和同步的衔接;编译器负责语义校验、IR转换、代码生成和编译。对于硬件映射已有明确方案,或需要细调访存、计算和并行流水的算子,这种方式尤其合适。
数据组织:Tensor表示GM中的数据,Tile表示片上数据块,RegTensor表示矢量寄存器中的数据。开发者根据算子需要确定每次处理多大一块数据,以及片上Buffer怎么使用。
任务划分:开发者在Kernel中用Vector和Cube执行域安排对应的计算,再根据启动的核数和核索引,确定每个核处理哪部分数据。需要逐线程处理时,可以在Vector执行域中启动SIMT Thread Block。
搬运与同步:开发者安排数据何时搬入片上、何时计算、何时写回,也要处理不同Pipe或不同核之间的数据依赖。能够由框架识别的依赖,可以借助自动同步;CV融合场景还可以用自动CV流水来编排计算。
编译与执行:开发者写好Kernel后,JIT负责检查程序、生成PyPTO IR和目标代码,并按需要编译、加载和下发。相同编译签名的Kernel可以在当前进程中复用。
产品支持情况#
Ascend 950PR/Ascend 950DT:支持
Atlas A3 训练系列产品/Atlas A3 推理系列产品:不支持
Atlas A2 训练系列产品/Atlas A2 推理系列产品:不支持